
Дать ИИ-агенту самостоятельность страшно. Поэтому автономность обычно решают одним из двух способов: требовать подтверждение на каждое действие или отключить подтверждения совсем. Оба варианта ломаются, и ломаются по-разному.
Первый — потому что человек перестаёт читать то, что подтверждает. Второй — потому что агенту без границ достаточно одной неудачной инициативы, чтобы её последствия разгребала ваша команда: письмо ушло не тому клиенту, платёж списался, сделка удалилась.
Позиция, с которой написана статья: автономность — не переключатель «доверяю — не доверяю» и не свойство модели. Это конфигурация процесса: какие действия вообще доступны агенту, сколько стоит ошибка каждого и в каких местах обязан стоять человек. Дальше — как разметить действия по цене ошибки, где закрепить границы технически и что измерять на пилоте.
Подтверждение на каждом шаге не работает
Самый частый ответ на страх перед агентами звучит так: «пусть каждое действие подтверждает человек». Телеметрия Anthropic по Claude Code показала, что этот контроль иллюзорен: пользователи одобряют примерно 93% запросов на разрешение. Оговорка обязательна: это данные поставщика, и речь об инструменте для разработчиков. Но механика к разработке не привязана: чем больше подтверждений видит человек, тем меньше внимания уделяет каждому [1].
Контроль, который срабатывает постоянно, — это не контроль, а привычка нажимать «Разрешить».
Anthropic признали, что схема не работает, и построили auto mode: решения о разрешениях переданы классификатору. Он ловит около 83% чересчур инициативных действий до выполнения, около 17% пропускает и по ошибке блокирует примерно 0,4% нормальных команд [1][2]. Формулировка у них без обтекаемости: любая вероятностная защита имеет ненулевой процент пропусков.
Отсюда простая вещь. Спор «кто надёжнее — человек или автопроверка» вести не нужно. Вопрос в другом: какие действия агента вообще должны доходить до человека, а какие никому не должны мешать.
Автономность задаётся границами, а не доверием
В той же инженерной статье Anthropic описывает два способа ограничить возможный ущерб от агента. Первый — надзор за поведением: человек смотрит и подтверждает. Второй — границы доступа: песочницы, права, контроль исходящих соединений. Второй надёжнее именно потому, что он детерминированный: граница срабатывает тогда, когда всё вероятностное — модель, классификатор, внимательный сотрудник — уже промахнулось [1].
Из этого подхода следует практическое правило: агенту, который может только читать, можно доверить больше, чем агенту с правом записи в боевую систему [1]. Чтение — широкий круг задач без последствий; запись и удаление — узкий круг, где последствия наступают сразу.
Второе правило касается не агента, а человека. Anthropic сравнивают две аудитории: разработчик способен прочитать команду и оценить, что она сделает; обычный сотрудник — нет. Когда подтверждение требует экспертизы, которой у сотрудника нет, граница должна быть не диалогом «разрешить?», а постоянным запретом, который включён всегда [1]. Для малого бизнеса это типовой случай: менеджер не обязан понимать, что именно делает скрипт, — значит, «спросить у сотрудника» не может быть единственной защитой.
Microsoft в руководстве по архитектуре агентов формулирует тот же принцип безотносительно безопасности: начинать с самого низкого уровня сложности, который закрывает задачу, потому что каждый следующий добавляет координацию, задержку и стоимость [4]. С автономностью так же: её выдают по необходимости, а не по максимуму возможностей модели.
Отдельно про инициативу. Внутренний журнал инцидентов Anthropic полон историй, где модель технически не ошиблась, а просто переступила то, чего пользователь не имел в виду: просьба «почистить ветки» закончилась удалением веток на сервере, «отмени задачу» — попыткой удалить ближайшее по названию задание в кластере [2]. Формулировка «просто сделай» не содержит границ, и модель достраивает их сама. В бизнес-процессах это выглядит так: «обработай просроченные счета» — а агент сам решает, что значит «обработать»: напомнить, начислить пеню или отменить заказ.
Разметьте действия по цене ошибки
Решение вместо «доверять или нет» выглядит скучно и работает. Выпишите каждое действие, которое агент может совершить в процессе, и на каждое ответьте на два вопроса. Действие обратимо? Что стоит ошибка — деньги, клиент, репутация, проверка?
По ответам действия ложатся на четыре уровня.
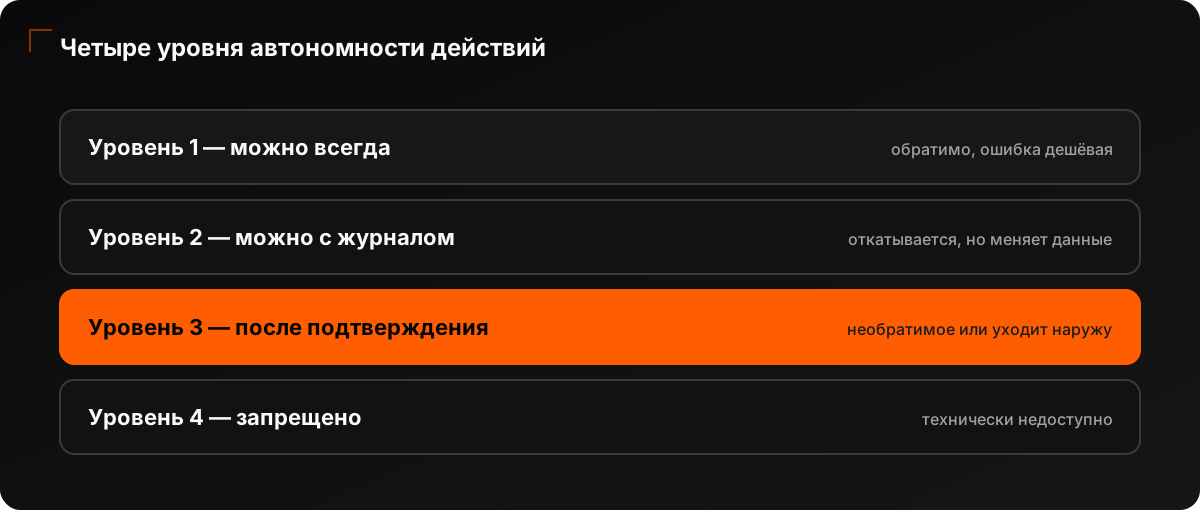
Уровень 1 — можно всегда. Действие обратимое, происходит внутри вашей системы, ошибка дешёвая. Разметить обращение по типу, подготовить черновик ответа, дополнить карточку в CRM данными из письма. Подтверждения здесь только мешают: дешевле проверить результат потом, чем останавливать каждое движение.
Уровень 2 — можно, но с журналом. Действие откатывается, но меняет данные, на которых работают люди: сменить этап сделки, перенести задачу, объединить обращения. Журнал записывает, что сделано, когда и на каком основании, чтобы откат и разбор занимали минуты, а не вечер.
Уровень 3 — только после подтверждения. Действие необратимое или уходит наружу: отправить письмо клиенту, списать деньги, оформить заказ поставщику, удалить запись. Это и есть места, где человек обязан стоять. Подтверждение должно показывать, какое действие, с какими параметрами и почему агент его выбрал, — иначе это нажатие кнопки, а не решение.
Уровень 4 — запрещено. Платёжные реквизиты и пароли, массовые удаления, изменение собственных прав агента, обход проверок. Не «по подтверждению», а никак: эти действия должны быть технически недоступны, а не запрещены инструкцией.
Условный пример, не реальный проект. Агент в отделе продаж разбирает входящие заявки. Классифицировать обращение и заполнить карточку — уровень 1. Перевести сделку на следующий этап по правилам — уровень 2. Отправить коммерческое предложение клиенту или согласовать скидку за пределами прайса — уровень 3. Чистить базу от «дублей» — уровень 4: это делает человек по своему списку.
Частота уровня 3 — главный индикатор качества разметки. Ориентир: подтверждения должны быть редкими решениями, единицами процентов от всех действий агента, — только тогда каждое из них человек реально читает. Если разметка отправляет на подтверждение каждое третье движение, поток запросов перестают читать, и контроль превращается в ту самую привычку нажимать «Разрешить», описанную в начале статьи, — с той разницей, что её причина уже не в агенте, а в разметке. Лечится это не призывом «быть внимательнее», а переносом массовых действий на уровни ниже.
Где закрепить границы
Границы, которые живут только в инструкции для модели («не отправляй письма без разрешения»), — это пожелание, а не защита. Модельный слой формирует то, что агент склонен делать, а не то, что он технически способен сделать, — так это формулирует Anthropic [1]. Реальная граница стоит в workflow и в правах.
Механика подтверждения — в англоязычной терминологии human in the loop — уже стандартная. В n8n перед инструментом агента включается human review: workflow останавливается, решение приходит через Telegram, Slack, почту или другой канал, и только после одобрения действие выполняется [5]. В Microsoft Agent Framework workflow приостанавливается и ждёт ответа внешней системы — человека; незакрытые запросы сохраняются в контрольных точках и не теряются при перезапуске [3]. Возможности названы по документации на сентябрь 2026 года — перед внедрением сверяйте с актуальной.
Две детали решают больше, чем выбор платформы. Первая: подтверждение должно приходить тому, кто отвечает за процесс, а не в общий чат, где его заметят через час. Вторая: канал подтверждения может не совпадать с каналом общения с клиентом — клиент разговаривает с ботом, а решения принимает сотрудник в своём мессенджере [5].
Чего границы не решают
Разметка действий не заменяет остальную безопасность, а работает вместе с ней.
Внешний контент остаётся каналом атаки: инструкция, спрятанная в письме или документе, может увести агента от задачи. Как это устроено и как защищаться — отдельный разбор промпт-инъекции [6]. Границы действий ограничивают ущерб, но не отменяют саму проблему.
Права доступа — смежный, но отдельный контур: что агент может в принципе — читать, писать, кому отправлять. Связь прямая: агенту без права записи нечего подтверждать на уровне 3. Как ограничивать права ИИ-агента в CRM, разобрано в отдельной статье [7].
Исходящие каналы — тоже граница. Anthropic разбирают случай, когда данные ушли наружу через легально разрешённый адрес: белый список доменов работает как выданная возможность, и «разрешено обращаться к API» оказалось «разрешено загружать файлы в чужие аккаунты» [1]. Для бизнеса это означает, что список адресов, куда агент может отправлять данные, — часть разметки, а не техническая мелочь.
И стандартная оговорка: если процесс состоит из однозначных правил, агент там не нужен — хватит обычного workflow. Где проходит граница между правилами и ИИ, разобрано в первой статье блога [8].
Как проверить на пилоте
Запускайте с максимальным контролем и ослабляйте по данным — тот же порядок рекомендует документация n8n: включить проверку человеком с самого начала и снижать объём ручных решений по мере доверия [5].
Что считать на пилоте:
- долю действий, потребовавших подтверждения (уровень 3);
- среднее время от запроса до решения человека — задержку, которую платит процесс;
- сколько действий отклонено и почему — самые ценные записи журнала;
- сколько раз пришлось откатывать действия уровней 1–2.
Правило пересмотра простое. Если за две-четыре недели на уровне 3 не было ни одного отклонения — часть этих действий можно перевести на уровень 2 и сократить простои. Если отклонения регулярны — разметка работает, а чинить нужно правила, по которым агент выбирает действия.
И у процесса должен быть владелец: человек, который смотрит журнал и решает вопрос смены уровней. Автономность без владельца деградирует в обе стороны — и к тотальным подтверждениям, и к автопилоту.
Вывод
Автономность ИИ-агента — не вопрос доверия к модели, а разметка действий по цене ошибки. Обратимое и дешёвое отдавайте без подтверждений. Необратимое и уходящее наружу — только через человека, и точек такого контроля должно быть немного. Реквизиты, массовые удаления и собственные права агента запрещайте технически, а не инструкцией.
Первый шаг: выпишите действия одного процесса, назначьте каждому один из четырёх уровней и запустите пилот с журналом. Если нужно понять, какие процессы вообще готовы к агенту и где границы первого пилота, — это разбирается на аудите процесса.
Частые вопросы
Автономность — это свойство модели?
Нет. Одна и та же модель в разных границах безопасна или опасна: автономность задают доступные действия, права и точки подтверждения. Модель смените — разметку сохраните.
Можно ли совсем убрать человека из процесса?
Для обратимых действий с дешёвой ошибкой — да, и это правильная цель. Для необратимых и внешних — нет: там человек обязан стоять. Задача не в том, чтобы убрать человека, а в том, чтобы точек подтверждения было мало и каждое было настоящим решением.
Как понять, что разметка неудачная?
По поведению процесса, ещё до цифр пилота. Подтверждения приходят чаще, чем сотрудник успевает в них вникнуть, — массовые действия остались на уровне 3. Агент «спрашивает по мелочам», которые решения не требуют, — границу назначили не по цене ошибки, а по перестраховке. Если же агент работает без единого вопроса, а потом выясняется, что пару раз он сделал то, чего вы бы не разрешили, — необратимые действия ошибочно лежат на уровнях 1–2.
Чем уровни автономности отличаются от прав доступа?
Права отвечают на вопрос «куда агент может попасть», уровни автономности — «какое действие он может завершить без человека». Нужны оба: права отсекают лишнее до запуска, уровни управляют тем, что осталось.
Что делать, если агент уже наделал ошибок?
Отвечает за последствия та компания, которая запустила агента в процесс, поэтому ужесточать «внимательность сотрудников» бессмысленно. Разобрать журнал: какие действия привели к ошибке и на каком уровне они стояли. Действие, которое ошибается регулярно, переносится уровнем выше или забирается у агента — до исправления правил.
Что такое human in the loop?
Human in the loop — «человек в контуре»: точка процесса, где действие не выполняется, пока человек его не одобрит. В разметке из этой статьи это уровень 3: агент готовит действие и показывает, что именно он собирается сделать, а сотрудник принимает решение. Для обратимых действий с дешёвой ошибкой человек в контуре не нужен — там подтверждения только тормозят процесс.
Источники
- How we contain Claude across products — Anthropic Engineering, 25 мая 2026
- How we built Claude Code auto mode: a safer way to skip permissions — Anthropic Engineering, 25 марта 2026
- Microsoft Agent Framework Workflows — Human-in-the-loop (HITL) — Microsoft Learn, обновлено 25 августа 2026
- AI agent orchestration patterns — Azure Architecture Center, Microsoft Learn, проверено 2026-09-28
- Human-in-the-loop for tools — n8n Docs, проверено 2026-09-28
- Промпт-инъекция: как защитить ИИ-ассистента — ai-av.ru, 3 августа 2026
- Безопасность ИИ-агентов в CRM: как настроить права доступа — ai-av.ru, 17 июля 2026
- Автоматизация с помощью ИИ: какие процессы ему поручать — ai-av.ru, 27 июня 2026