
«У современных моделей контекст — миллион токенов. Зачем нам векторные базы и весь этот RAG — просто загрузим наши документы в чат». Аргумент звучит разумно: действительно, зачем строить систему, если всё влезает в один запрос.
Моя позиция обратная. База знаний компании — архив с владельцем, правами и жизненным циклом документов; миллион токенов — лишь объём рабочей памяти одного запроса. Документы в это окно поместятся, но цена вопроса, точность ответа на большом объёме и права доступа от этого не меняются. Ниже — что контекстное окно даёт и чего не даёт, расчёт цены одного вопроса и граница, за которой база знаний с поиском становится рациональнее.
Контекстное окно — рабочая память, а не архив
Контекстное окно — всё, что модель видит при ответе: инструкция, история диалога, приложенные документы, вопрос. Сюда же входит и ответ, который модель генерирует. Всё, что в окне, отправляется в каждом запросе и оплачивается как вход.
Размеры окон выросли заметно. У актуальных моделей Claude окно — миллион токенов по умолчанию, без бета-режима и надбавки к тарифу; у Sonnet 4.5 и более старых моделей — 200 тысяч [1]. У многих моделей Gemini — миллион токенов и больше [3]. Но картина неровная: в Yandex AI Studio у YandexGPT Pro 5.1 контекст — 32 768 токенов, а из открытых моделей — 131–262 тысячи [7]. Для российской компании это практический вопрос: «миллион токенов» есть не у всякой модели, до которой можно дотянуться.
Для ориентира — что такое миллион токенов по объёму. По оценке Google, это около 50 000 строк кода или восемь романов средней длины [3]. В один запрос к модели Claude с окном 1 млн можно приложить до 600 страниц PDF [1]. Типовой регламент компании, прайс, пара десятков инструкций — да, помещается с запасом.
Проблема не в объёме. Проблема в том, что происходит с качеством ответа, когда объём заполняется.
Что происходит, когда документы грузятся целиком
Сам Anthropic формулирует это прямо: больше контекста — не значит лучше. С ростом числа токенов точность и способность модели вспомнить нужный фрагмент деградируют — этот эффект Anthropic называет context rot [1]. В инженерной статье объясняется механика: у модели ограниченный «бюджет внимания», и с ростом контекста он растягивается; деградация проявляется у всех моделей, различается только скорость [2].
Google подтверждает ту же особенность со своей стороны. На одиночный спрятанный факт модели отвечают почти идеально — до 99%. Но в реальных задачах фактов много: при поиске нескольких сведений точность «не та же» и сильно зависит от контекста [3]. Плюс задержка: чем длиннее запрос, тем дольше модель выдаёт первый токен — для пользователя это «бот думает» [3].
Влезает — не значит найдётся. Регламент на четырёхсотой странице никуда не денется, но вероятность, что модель найдёт и правильно использует именно его в окружении сотен страниц другого текста, ниже, чем если бы поиск доставил только его.
Сколько стоит каждый вопрос
Второе различие — экономика, и она считается по журналам, а не по ощущениям.
Если документы целиком входят в каждый запрос, вы платите за весь набор при каждом вопросе. Если работает база знаний, в запрос уходят только найденные фрагменты — порядка тысяч токенов вместо сотен тысяч.
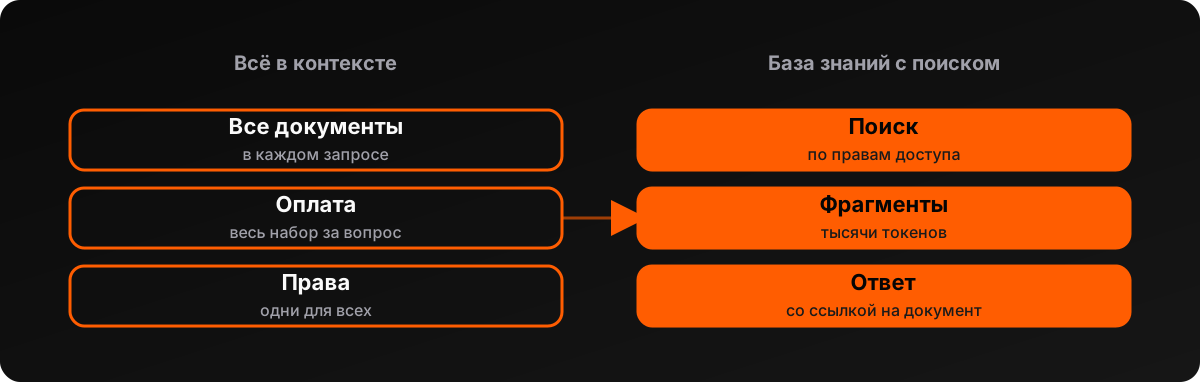
Условный пример, не реальный проект. Пусть база документов — 300 000 токенов (несколько сотен страниц), ассистент отвечает на 1000 вопросов в месяц, цена входа — уровня Claude Sonnet, $3 за миллион токенов [4]. С полным контекстом входные токены за месяц: 300 000 × 1000 = 300 миллионов, то есть около $900. С поиском: на вопрос уходят 2–3 тысячи токенов фрагментов — те же 1000 вопросов обойдутся в $6–9. Разница — от ста до полутора сотен раз, и в абсолютных деньгах она растёт вместе с числом вопросов.
Кэширование смягчает картину, но частично. У Anthropic чтение кэшированного контекста стоит $0,30 вместо $3 за миллион, запись — дороже обычного входа, а живёт кэш около пяти минут [4]. Google называет кэш основной оптимизацией длинного контекста: запрос с кэшем у Gemini Flash обходится примерно в четыре раза дешевле, но хранение оплачивается почасово [3]. При плотном потоке вопросов кэш работает. При редких вопросах он истекает между ними — и каждый новый вопрос снова оплачивает полный набор. И ни кэш, ни большое окно не меняют остальное: права доступа, актуальность и проверяемость ответа остаются отдельными задачами.
Что база знаний даёт кроме цены
Деньги — не единственный аргумент, но самый легко проверяемый.
Права доступа. В контексте лежит всё, что вы туда положили, — для каждого, кто задаёт вопрос. Если в наборе есть документы «только для руководителей», загрузить их целиком значит показать их всем. В базе знаний поиск фильтруется по правам: модель получает только те фрагменты, которые спрашивающему можно видеть. Решение о доступе принимает программа — поисковый фильтр, а не сама модель.
Актуальность. Обновился прайс или регламент — в базе знаний поиск сразу находит новую версию. В сценарии «всё в контексте» пересобирайте набор документов вручную и следите, чтобы старая версия не осталась в истории диалога. База знаний делает актуальность управляемой: у документов жизненный цикл, а не разовая загрузка [5].
Проверяемость. Ответ, собранный по найденным фрагментам, можно снабдить ссылкой на документ — и сотрудник, и клиент видят, откуда взята информация. Уверенный ответ «из памяти всего окна» проверить не на что. Когда ассистент отвечает клиенту о тарифах или сроках, это различие стоит дорого.
Тестируемость. База знаний с поиском проверяется по тестовому набору: отдельно поиск, отдельно ответ, отдельно отказ, когда ответа в документах нет [6]. С полным контекстом тестирование тоже возможно, но настройке поддаётся меньше: крути не крути — в запросе по-прежнему всё.
Когда достаточно длинного контекста
Справедливости ради: заводить базу знаний ради пары десятков страниц — лишняя работа. Длинный контекст — правильный выбор, когда:
- задача разовая: разобрать договор, сравнить пять счетов, сделать сводку по отчётам за квартал;
- документов немного, а вопросы редкие — инструкция на двадцать страниц и пара регламентов спокойно помещаются в контекст;
- нужен прототип: за вечер проверить идею на своих документах, не поднимая инфраструктуру.
Признак простой. Задача одноразовая или вопрос возникает изредка — грузите файлы целиком. Вопросы одни и те же, приходят регулярно, а документы обновляются — это работа для базы знаний.
Граница есть и в другую сторону. Если документов сотни тысяч страниц, спор «контекст или поиск» вторичен: сначала наводится порядок в самих документах — что вообще можно показывать ассистенту и откуда это брать.
Как проверить на своих данных
Этот выбор не нужно принимать на веру — он проверяется за неделю.
- Соберите 30–50 реальных вопросов сотрудников или клиентов. Не придуманных: реальные вопросы короче и конкретнее того, что вы ожидаете.
- Подготовьте эталоны: для каждого вопроса — документ и фрагмент, где лежит правильный ответ.
- Прогоните оба варианта: файлы целиком в контексте и поиск по базе. Считайте четыре числа: долю вопросов, где найден правильный фрагмент; долю верных ответов; стоимость одного вопроса; задержку ответа.
- Сравните. Если полный контекст на вашем объёме отвечает так же точно — у вас просто мало документов, и база знаний пока не нужна. Если поиск проигрывает — причина чаще в состоянии документов, а не в самом подходе.
Тестовый набор и приёмка по нему — та же методика, которой проверяется любой RAG-ассистент до запуска [6]. Стоимость вопроса считается по журналам провайдера [4] — так же считают и счёт за нейросеть целиком.
Вывод
Контекстное окно — рабочая память одного запроса, и миллион токенов не превращает её в архив компании. Разовую задачу решайте файлами целиком. Для повторяющихся вопросов клиентов и сотрудников рациональнее база знаний с поиском: при регулярном трафике она дешевле в пересчёте на вопрос, точнее на большом объёме и позволяет управлять правами и актуальностью документов.
Первый шаг — собрать реальные вопросы и сравнить оба варианта на своём наборе документов: доля правильных ответов и цена одного вопроса скажут больше, чем любые аргументы со стороны.
Если нужно понять, какие данные уже готовы, где границы пилота и что потребует доработки, — это разбирается на аудите процесса.
Частые вопросы
Сколько документов помещается в миллион токенов?
По оценке Google — около восьми романов средней длины или 50 000 строк кода [3]. В запрос к модели Claude с окном 1 млн можно приложить до 600 страниц PDF [1]. Но ёмкость — не то же самое, что точность: при поиске нескольких фактов в большом объёме качество снижается [1][3].
Контекстное окно — это память чат-бота?
Нет. Контекст — содержимое одного запроса. Память диалога, долговременные предпочтения клиента и данные из CRM — разные хранилища с разными правилами обновления, и смешивать их в одном месте не стоит. Чем память диалога отличается от базы знаний, я разбирал в отдельной статье.
Можно ли просто загрузить все документы в ChatGPT?
Для разовой задачи — да, это нормальный способ. Для постоянных вопросов команды или клиентов появляются три проблемы: каждый вопрос оплачивает весь набор, права доступа не различаются и актуальность приходится поддерживать вручную. Отдельно стоит проверить, куда сервис загружает ваши документы и кто может к ним попасть.
Что дешевле — длинный контекст или база знаний?
Зависит от частоты вопросов и объёма документов. При редких вопросах и малом наборе контекст дешевле, потому что база знаний не окупается. При регулярном трафике поиск выигрывает на порядок и больше; конкретные цифры для ваших объёмов даёт расчёт по журналам провайдера.
RAG — это то же самое, что база знаний?
Нет. База знаний — хранилище документов компании с процессом обновления и правами. RAG — способ построить ответ: система находит релевантные фрагменты и передаёт их модели вместе с вопросом. База знаний без RAG — просто документы; RAG без управляемой базы знаний — поиск по мусору.
Источники
- Context windows — Claude Platform Docs (Anthropic), проверено 2026-09-25
- Effective context engineering for AI agents — Anthropic Engineering, 29 сентября 2025
- Long context — Gemini API Docs (Google), обновлено 2026-06-22, проверено 2026-09-25
- Pricing — Claude Platform Docs (Anthropic), проверено 2026-09-25
- Обновление базы знаний для ИИ: актуальность RAG — ai-av.ru, 2026-07-27
- Тестирование чат-ботов с ИИ: проверка RAG до запуска — ai-av.ru, 2026-07-15
- Модели генерации — Yandex AI Studio (Yandex Cloud), проверено 2026-09-25