
Ассистент уже отвечает клиентам, объём обращений не меняется, а счёт за API в конце месяца снова больше ожидаемого. Типичная реакция в этот момент — «перейдём на модель подешевле». Иногда это помогает. Чаще — нет, потому что деньги утекают не в цену модели, а в то, сколько токенов и вызовов порождает сам процесс.
Моя позиция тут простая: стоимость ИИ-ассистента — это не фиксированная «цена нейросети», а произведение трёх множителей. Цена за токен выбранной модели умножается на количество токенов и на количество вызовов. Каждый множитель настраивается отдельно, и по порядку отдачи они разные. Поэтому первый шаг — не смена модели, а расчёт стоимости одного обращения и разбивка счёта по статьям.
Из чего складывается счёт
Токены в нейросети — это фрагменты текста длиной в несколько символов, и именно по ним модели тарифицируются. В один запрос уходит два вида токенов, и стоят они по-разному. Входные — всё, что вы отправляете модели: инструкция, история диалога, найденные документы. Выходные — то, что модель генерирует. У моделей Claude выходные токены примерно в пять раз дороже входных: у Sonnet 4.5 это $3 против $15 за миллион токенов, у Haiku 4.5 — $1 против $5 [1]. То же разделение действует у российских провайдеров: Yandex Cloud AI Studio выставляет счёт за 1000 входящих токенов отдельно от сгенерированных [5].
Отсюда формула одного вызова:
стоимость вызова = входные токены × цена входа + выходные токены × цена выхода.
Но ассистент редко делает один вызов. Пока клиент ждёт ответ, система успевает определить тему запроса, найти фрагменты базы знаний, сформулировать ответ, иногда перепроверить его. Каждый шаг — отдельный вызов с собственным контекстом. Если ассистент построен как агент с циклом, число шагов заранее не фиксировано: модель может решить проверить ещё раз — и счёт это учитывает. Плюс повторы после сбоев и прогоны на тестах, которые тоже списываются с баланса.
Так разрыв между «я думал, будет дёшево» и реальным счётом объясняется не жадностью провайдера, а суммой, которую никто не считал.
Посчитайте стоимость одного обращения
Главный показатель здесь не месячный счёт, а стоимость одного обработанного обращения. Она превращает абстрактные «расходы на ИИ» в управляемую цифру, которую можно сравнивать с зарплатой оператора и снижать по частям.
Порядок такой.
- Возьмите журналы использования за 2–4 недели. У провайдеров они есть всегда: в ответе API возвращаются счётчики input_tokens и output_tokens по каждому вызову [2], в кабинетах Microsoft и Yandex эти же данные доступны через отчёты по использованию и биллингу [4][5]. Кэшированные токены видны отдельно — это пригодится дальше.
- Сгруппируйте вызовы по типам операций: классификация входящего запроса, поиск по базе, ответ клиенту, внутренняя проверка. Стоимость складывается по формуле из предыдущего раздела, отдельно по каждой группе.
- Разделите сумму по группе на число обработанных обращений. Получите стоимость одного ответа, одной классификации, одного полного цикла.
После этой разбивки обычно видно, что счёт собирается из двух-тёх статей, а не размазан равномерно. Дальше работает не общая «оптимизация затрат», а точечные решения по конкретной статье.
Та же разбивка по этапам цепочки выручает и в соседней проблеме: если ассистент отвечает медленно, там тоже ищут самый медленный этап, а не сразу меняют модель.
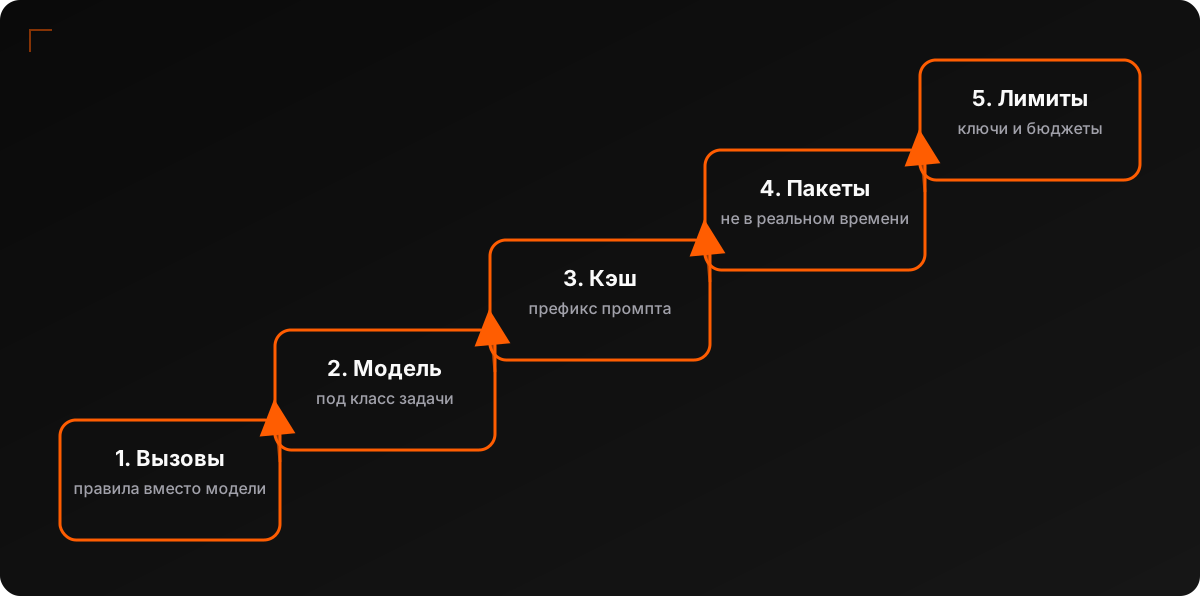
Рычаги снижения — по порядку
1. Сначала уберите лишние вызовы
Самый недооценённый рычаг — не отправлять модели то, с чем она не нужна. Вопрос «какой у меня тариф» не требует нейросети: это поиск по двум записям. Если типовые ветки диалога закрыть правилами и скриптами, а модель оставить там, где формулировка запроса непредсказуема, счёт падает без всякой потери качества. Где проходит граница между правилами и ИИ, я разбирал в отдельной статье — она как раз о том, как разделить процесс по логам, а не «на глаз».
Туда же — лишний контекст. Отправлять в каждый запрос всю базу знаний вместо нескольких найденных фрагментов — значит платить за тысячи входных токенов на ровном месте и заодно ухудшать ответ.
2. Подберите модель под класс задачи
Модели одной платформы сильно различаются в цене: Haiku 4.5 втрое дешевле Sonnet 4.5 и по входу, и по выходу [1]. Логика выбора простая: маршрутизация, извлечение полей, короткие классификации не требуют самой умной модели. Сложные ответы, где цена ошибки высока, — требуют.
После смены модели качество проверяется на том же тестовом наборе, что и при запуске. Дешёвая модель, которая возвращает клиентов к оператору, дороже дорогой — разница уйдёт в зарплату. Приёмку ассистента по тестовому набору — поиск, ответ, отказ, передача человеку — я разбирал отдельно, там же есть готовый чек-лист.
3. Включите кэширование
Кэш переиспользует повторяющуюся часть запроса: инструкцию, описание инструментов, стабильный контекст. У Anthropic чтение из кэша стоит 10% цены входных токенов, запись — на 25% дороже обычного входа; кэш живёт 5 минут и обновляется при каждом обращении [1]. У OpenAI кэширование работает автоматически для промптов от 1024 токенов, держится 5–10 минут после последнего запроса, а по отдельным моделям доступно расширенное хранение до суток; скидка на повторно используемые токены — по данным OpenAI, до 90% [2].
Условий, при которых кэш работает, немного, и все они важны. Повторяющаяся часть должна стоять в начале запроса и совпадать байт в байт. Если менять её с каждым вызовом — кэша нет. У Anthropic смена описания инструментов сбрасывает кэш целиком [1]. И он не окупается на коротких промптах: порог кэширования — от 1024 токенов, у части моделей выше.
Для ассистентов с большим системным промптом и постоянной инструкцией это обычно самый быстрый способ сократить счёт.
4. Переведите массовые задачи в пакетный режим
Обработка архива документов, расследование старых заявок и оценка базы лидов не требуют ответа за секунду. У OpenAI за готовность подождать до 24 часов пакетный API даёт скидку 50% против синхронных запросов [3]. У Azure OpenAI ставка за токен зависит от модели и типа развёртывания, а для стабильной нагрузки есть commitment-тарифы — фиксированная плата за предсказуемый расход вместо оплаты за каждый токен [4]. Всё, что не в реальном времени, можно и нужно считать дешевле.
5. Поставьте лимиты и наблюдайте
Полностью автоматической защиты нет даже у крупных провайдеров: в Azure OpenAI жёсткого потолка расходов не предусмотрено — только бюджеты и оповещения при приближении к порогу [4]. Поэтому минимум гигиены такой: отдельный API-ключ на каждый контур — ассистент, тестовый прогон, внутренний сервис; предоплаченный баланс вместо постоплаты, где это возможно; ежемесячный просмотр разбивки по ключам. Стоимость сломанного цикла агента тогда видна в тот же день, а не в конце месяца.
Условный пример: как множители работают вместе
Разберём арифметику на условном примере — не реальном проекте. Ассистент поддержки обрабатывает 1000 обращений в месяц, на каждое уходит два вызова модели. Входные токены одного вызова — 8000: из них 6000 — стабильная инструкция, ещё 2000 — найденные фрагменты базы знаний, которые меняются от обращения к обращению и кэшироваться не могут. Ответ — 500 токенов. Инструкция проходит порог кэширования обеих моделей: 1024 токена у Sonnet 4.5 и 4096 у Haiku 4.5 [1]. Тарифы — данные Anthropic на дату написания; для рублёвых провайдеров логика та же, отличаются цены [5].
| Вариант | Расчёт на обращение | Итого за месяц |
|---|---|---|
| Sonnet 4.5, без кэша | 2 × (8000 × $3/1 млн + 500 × $15/1 млн) ≈ $0,063 | ≈ $63 |
| Sonnet 4.5, инструкция (6000) в кэше | 2 × (6000 × $0,3/1 млн + 2000 × $3/1 млн + 500 × $15/1 млн) ≈ $0,031 | ≈ $31 |
| Haiku 4.5, без кэша | 2 × (8000 × $1/1 млн + 500 × $5/1 млн) ≈ $0,021 | ≈ $21 |
| Haiku 4.5, инструкция (6000) в кэше | 2 × (6000 × $0,1/1 млн + 2000 × $1/1 млн + 500 × $5/1 млн) ≈ $0,010 | ≈ $10 |
Разница между верхним и нижним вариантом — примерно в шесть раз на одинаковых обращениях. При этом столбец «инструкция в кэше» показывает верхнюю границу выгоды: чтение из кэша стоит 10% цены входа, но запись — на 25% дороже, а живёт кэш пять минут. При 1000 обращений в месяц паузы между ними обычно длиннее, поэтому часть вызовов начнётся с записи, а не с чтения, и реальная экономия окажется между строками «без кэша» и «инструкция в кэше». Отсюда практический вывод: не существует «самого дешёвого варианта вообще» — есть сочетание, которое считает по вашим журналам и вашему потоку.
И одна оговорка. Если после смены модели ассистент начал возвращать клиентов к операторам, экономия в $50 превращается в несколько часов работы специалистов. Считать нужно полную стоимость процесса, а не строку в счёте за API.
Когда экономить не нужно
Сотни обращений в месяц на дешёвой модели дают счёт, который проще не трогать, чем оптимизировать: часы разбора стоят дороже возможной экономии. Рычаги из этой статьи имеет смысл применять, когда ассистент обрабатывает заметный поток, в счёте появились десятки долларов и больше, и разбивка уже сделана.
Не экономьте там, где высока цена ошибки: юридические формулировки, деньги, медицинские и технически опасные ответы. И не начинайте со смены модели, если счёт растёт из-за повторов после сбоев — сначала чините сам процесс, иначе модель просто будет чаще повторять неудачные вызовы.
Вывод
Решение начинается с одной цифры — сколько стоит одно обработанное обращение. Посчитайте её по журналам за 2–4 недели, найдите статью счёта, которая собирает основную сумму, и начните с рычага, который её уменьшает.
Если хотите разобраться, где именно в вашем процессе уходят токены и что сократить без потери качества, — это стандартная часть аудита процесса перед оптимизацией.
Частые вопросы
Что такое токены в нейросети простыми словами?
Модель не читает текст по буквам: она режет его на короткие отрезки — токены — и меряет в них объём работы, поэтому тарифы публикуются «за миллион токенов», а не «за вопрос». Для счёта важно следствие: платите вы не за фразу клиента, а за весь контекст, который уходит модели, плюс за её ответ. Один и тот же вопрос может стоить по-разному — всё решает объём контекста, а не длина фразы [1].
Сколько токенов в одном запросе?
Фиксированного числа нет: в начале диалога хватает сотен токенов, а к середине счёт идёт на тысячи — контекст растёт вместе с историей. Свои реальные цифры видно в счётчиках, которые провайдеры отдают вместе с каждым ответом модели: в логах API [2] и в отчётах по использованию в кабинете [4][5]. Ориентироваться на «среднюю длину вопроса» бессмысленно — тарифицируется контекст целиком.
Можно ли установить жёсткий лимит расходов на API?
У OpenAI практичный вариант — предоплаченный баланс: списания идут с пополненного счёта, и уйти в минус нельзя. В Azure OpenAI жёсткого потолка нет — настроить можно бюджеты и оповещения о приближении к порогу [4]. Уточните механику у своего провайдера до запуска, а не после первого счёта.
Почему кэширование не даёт экономии?
Три частые причины: повторяющаяся часть промпта меняется от запроса к запросу, промпт короче порога кэширования (1024 токена и выше — зависит от модели), или описание инструментов обновляется между вызовами и сбрасывает кэш [1]. Проверьте, что статичный контекст стоит в начале запроса и действительно не меняется.
Что выгоднее: кэш или более дешёвая модель?
Это не конкуренты, а разные множители, и они складываются. Кэш снижает цену входных токенов, смена модели — цену и входа, и выхода. На коротких диалогах сильнее смена модели, на длинных стабильных промптах — кэш. Считать нужно по своим журналам.
Как часто пересматривать стоимость?
Тарифы меняются несколько раз в год, причём в обе стороны. Цены в этой статье — данные поставщиков на 22 сентября 2026 года; перед решением о смене модели проверьте актуальный прайс провайдера и пересчитайте стоимость обращения по свежим журналам.
Источники
- Prompt caching — Anthropic Docs, проверено 2026-09-22
- Prompt caching — OpenAI API Documentation, проверено 2026-09-22
- Batch API — OpenAI API Documentation, проверено 2026-09-22
- Plan and manage costs — Microsoft Foundry, Microsoft Learn, обновлено 2026-08-27
- Правила тарификации для Yandex AI Studio — Yandex Cloud, проверено 2026-09-22